QQ扫一扫联系
OpenAI 的开源语音识别模型 Whisper,现在不用敲命令行,装个桌面软件就能跑。
给视频配字幕、把会议录音变文字,过去要么传到在线服务排队等结果,要么自己装 Python 环境踩依赖坑。Whisper 是 OpenAI 开源的语音识别模型,用 68 万小时音频训练,能转写和翻译近百种语言,而且完全开源免费。现在它的门槛降到了「会双击安装包」。模型跑在你自己电脑上,音频一个字节都不用交出去。
具体怎么用?三步。
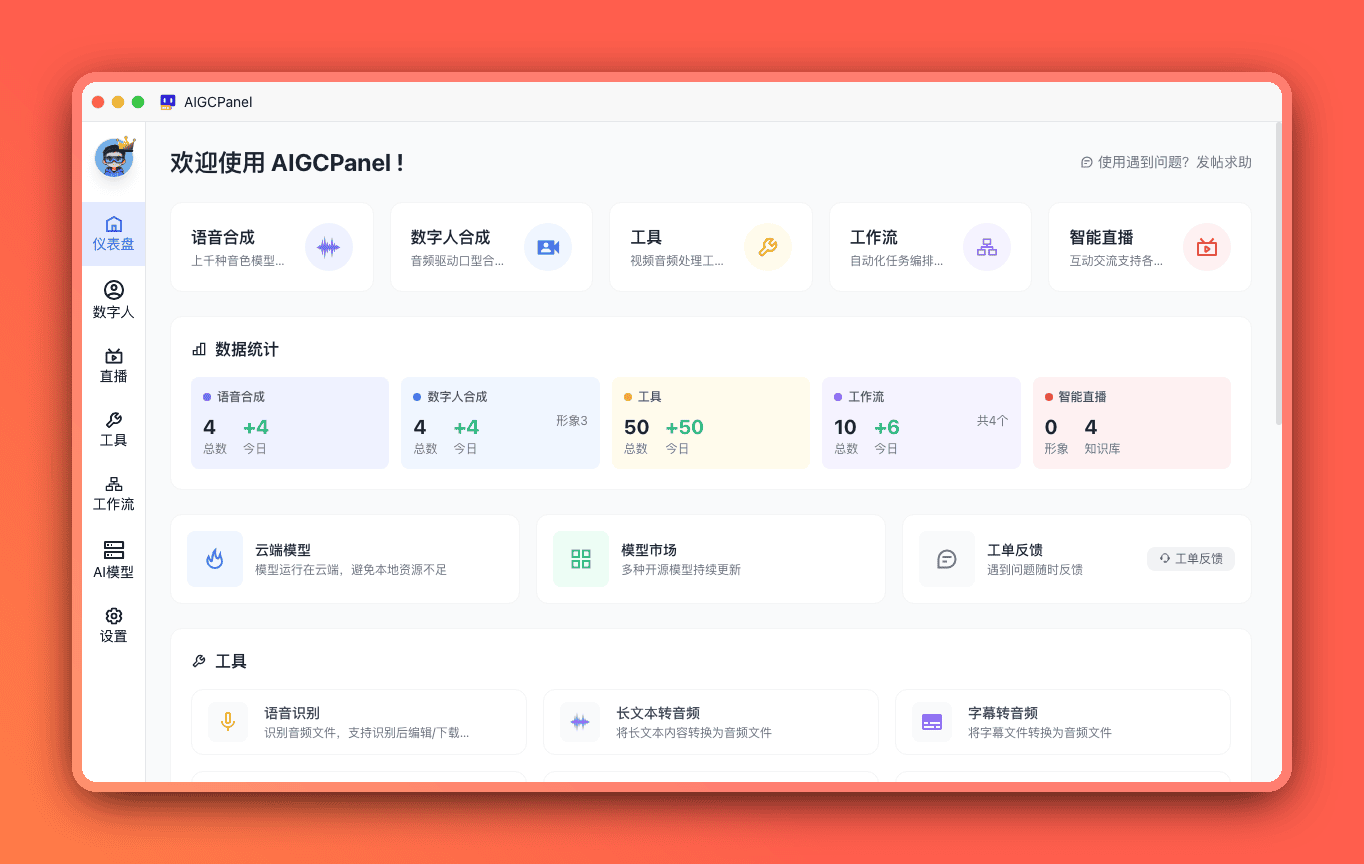
第 1 步:装上 AIGCPanel
在官网 aigcpanel.com 下载安装包,Windows / macOS / Linux 都有,双击安装就行。这是一款一站式 AI 数字人桌面应用,Whisper 语音识别是它模型市场里的一员。
第 2 步:模型管理里把 Whisper 点亮
打开「模型管理」找到 Whisper,点一下启动包就自动下载好了,Python、依赖、ffmpeg 这些都不用你装。下载时可以选三档大小:base 最快、占用最低,medium 最准、也最慢,small 居中。软件用的是优化过的轻量版引擎,占的空间和显存都比原版小一截。
硬件上,有显卡就自动用显卡加速,没有就自动用 CPU,什么都不用你设置。8G 内存的电脑就能跑 base,medium 建议再备 4G 显存。模型是免费的,你省下的是过去折腾环境的那些晚上。
第 3 步:上传音频,出字幕
在工具箱的「声音识别」里上传音频,点一下。一段 10 分钟的会议录音,跑完拿到的是一份可以直接复制进文档的文字记录,每句话前面带着开始和结束的时间点,还能直接导出成字幕文件。识别结果自动加标点,语言选自动检测就行,中英混说的素材不用手动切换,粤语也会按中文来识别。想翻译的话还有「翻译为英文」任务可选。
几个细节
会议纪要、视频字幕、外语内容的英文转写,Whisper 已经把能力给足了,AIGCPanel 补上的只是最后一步,让它像普通软件一样打开就能用。语音变成文字只需要三步,省下来的时间,还给创作本身。
你最想把哪段音频丢进去试试?是积攒了很久的会议录音,还是一直欠着字幕的视频?评论区聊聊。