QQ扫一扫联系
100M 参数、两个 CPU 核、还能克隆声音,现在装它不用碰命令行。
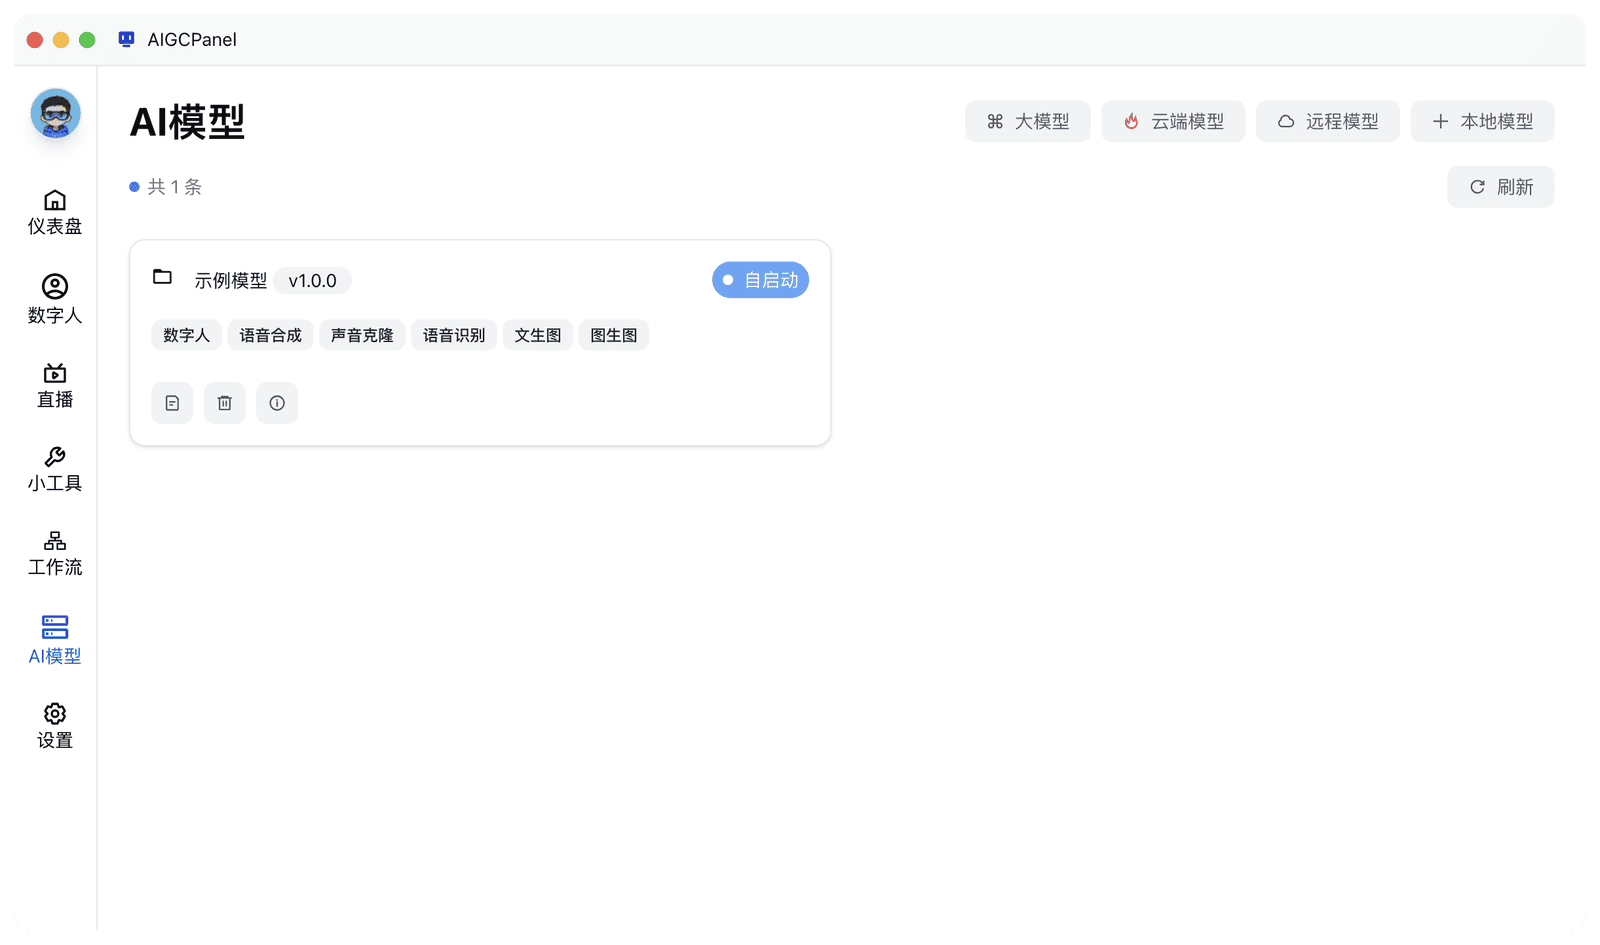
Pocket TTS 是 Kyutai 今年 1 月开源的语音合成模型,官方的定位很直白:塞得进 CPU,也塞得进口袋。AIGCPanel 把这个模型的服务端包做好了,模型、运行环境、推理进程、结果文件全是现成的。打开软件、下载、启动,这三下之后你就有一个本地 TTS 可以用,不用先跟 CUDA 搏斗。
先划重点:这是英文模型。上游已经支持英语、法语、德语、西班牙语、葡萄牙语、意大利语、荷兰语,AIGCPanel 目前这个包锁的是英文权重,合成中文会被直接拦下,不会给你一段莫名其妙的音频。
把模型跑起来只是一次实验,让它一直跑得稳才算产品。
规格先摆在这
不用显卡,两个 CPU 核就够
旧笔记本,或者没装独显的办公机,都能直接合成,风扇不会跟着起飞。
技术上它走的是 CALM 那条路:文本进 Transformer,直接在音频 codec 的连续帧上生成,最后解码成波形,中间没有「先把音频压成离散 token 再猜」这一步。少一次有损压缩,100M 参数也能撑起能听的音质。
官方给的数字是只占 2 个 CPU 核,MacBook Air M4 上约 6 倍实时,首块音频延迟约 200ms。这组数字是在单核很强的机器上测出来的,老机器更接近 1 倍实时,建议先拿一段短文本试水。
GPU 这件事官方讲得很实在:Apple Silicon 上没测到加速,4 核 x86 云机器配一张 T4 才有约 2.6 倍。所以这个包干脆按纯 CPU 来,加载时只记录 Device: cpu,不为一张用不上的显卡去校验驱动。
26 个音色,加一段音频就能克隆
预设音色里英文有 21 个:alba、marius、anna、mary、peter_yearsley……挑一个就能合成。想用自己的声音,传一段参考音频,模型照着它念。
参考音频别随便录。Kyutai 的原话是,音色、情绪、口音、节奏,连同混响和麦克风条件都会被一起还原——一段带底噪的录音,合成出来也带着底噪。社区里常用的长度是 5 到 20 秒,先降噪再喂进去,差别听得出来。
工程上的优化在缓存:预设音色从随包的模型缓存里读 embedding,参考音频则编码成一份 voice state,同一个音色连续合成多段,只编码一次。
克隆出来的声音,连你录音里的回声都会一起搬过来。
长稿子一次读完
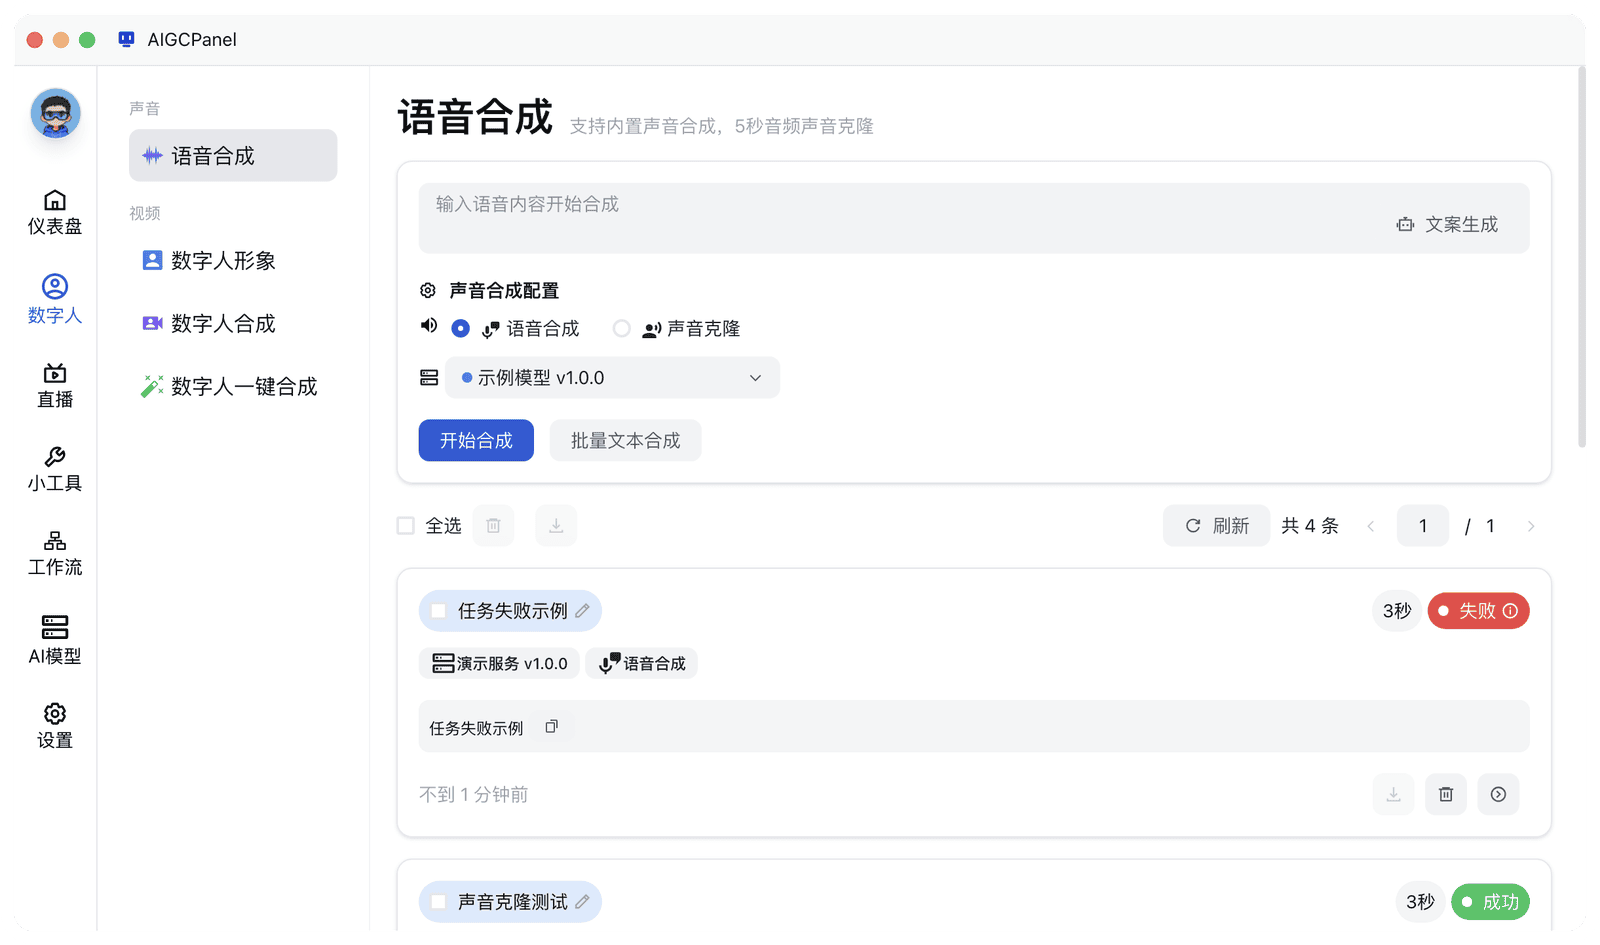
几千字的英文稿丢进去,不会合成到一半卡住。服务端先按句子切开,逐句合成再按时序拼回去,进度条一格一格走,你能看见它到了哪。
切句有个坑:直接拼接会把 Hello, this 拼成 Hello,this,单词读变形,听感上就是音频和文字对不上。这个包保留了原文的词间距与标点,专门绕开它。
有一点要说清楚:这条路是批量出文件,不是流式对话。模型本身首块音频 200ms、可以边生成边播,但 AIGCPanel 现在的用法是等整段合成完再看结果。
装完就不用管
稳不稳,看几个藏在后面的地方。
权重校验。28 个权重文件逐个比对官方字节数和 sha256,对不上直接报错。权重坏掉最麻烦的地方不是报错,是它安静地跑起来,然后给你一段听不出哪里不对的音频。
默认 int8。官方动态量化默认开着,内存降下来、速度提上去;量化失败自动回退原始精度,不会为了省内存把服务搞挂。顺带一提,这个量化在 CUDA 上用不了,纯 CPU 反倒是它的舒适区。
种子复现。同一个种子加同一段文本,输出稳定,批量配音不用每次抽卡;采样温度每次合成后自动恢复,任务之间不会互相污染参数。
中文拦截。文本里出现中日韩、俄、阿、希伯来、泰文字符,任务直接返回「仅支持英文文本」,服务继续待命,不产出错误音频。
下载走 ModelScope 公开镜像,国内拉权重不用为网络折腾。
上手就三步
第一步,下载并安装 AIGCPanel,Windows 和 macOS 都有,Linux 版本还在完善。第二步,在模型页找到 Pocket TTS,等权重下完,点启动。第三步,进「语音合成」选它,填一段英文、挑个音色,点生成,音频就出现在任务列表里。
不需要自己装 Python 或 PyTorch,这些都在包里。权重和推理都在本机,装完之后断网也能继续用。
它不适合谁
要合成中文的,这个包现在给不了。要精细控制情感、停顿、重音的,它也没有这些参数,效果靠参考音频本身。要做实时语音对话的,等流式接入再看,现在更适合先把文件出好。
你会先拿它念什么? 一段产品文案、一篇英文博客,还是你收藏很久的那段独白。跑完回来聊聊,哪个音色最像真人。
不必为了一段声音去买显卡,但值得为它录一段干净的参考音频。