QQ扫一扫联系
0.6B 的语音识别模型装进桌面软件,长录音不用上传,也不按分钟付费。
两小时的访谈、一节课的直播回放、一段带 BGM 的短视频,要变成文字,过去要么传上云端按分钟计费,要么自己装 Python、配 CUDA、写几十行推理脚本。Qwen3-ASR-0.6B 是通义千问开源的多语言语音识别模型,AIGCPanel 是开源的 AI 数字人桌面软件(Apache-2.0,社区版免费)。两者接上之后,转写变成了选文件、点「开始识别」。 模型的胜负写在跑分表上,工具的价值在你点下「开始识别」之后。
官方评测的数字摆在一起,有点反直觉。AISHELL-2 测试集,Qwen3-ASR-0.6B 错误率 3.15%,Whisper-large-v3 是 5.06%;WenetSpeech 网络场景 5.97% 对 9.86%;方言集 KeSpeech 7.08% 对 28.79%;粤语 CV-yue 9.50% 对 16.23%。Whisper-large-v3 参数量约 1.5B,是它的两倍多。
| 测试集 | 0.6B | 1.7B | Whisper-large-v3 | Doubao-ASR(云端) |
|---|---|---|---|---|
| AISHELL-2 | 3.15 | 2.71 | 5.06 | 2.85 |
| WenetSpeech 网络 | 5.97 | 4.97 | 9.86 | N/A |
| KeSpeech 方言 | 7.08 | 5.10 | 28.79 | 5.27 |
| GigaSpeech(英文) | 8.88 | 8.45 | 9.76 | 9.55 |
(错误率,越低越好,数据来自 Qwen3-ASR 官方仓库)
它不是全面第一:AISHELL-2、KeSpeech 上豆包的云端 API 更低,同门的 1.7B 每个集子都更好。0.6B 赢在体量和部署,不是赢在每一行。落到你身上,就是一张消费级显卡能本地跑完整段中文录音,文件不出本机。
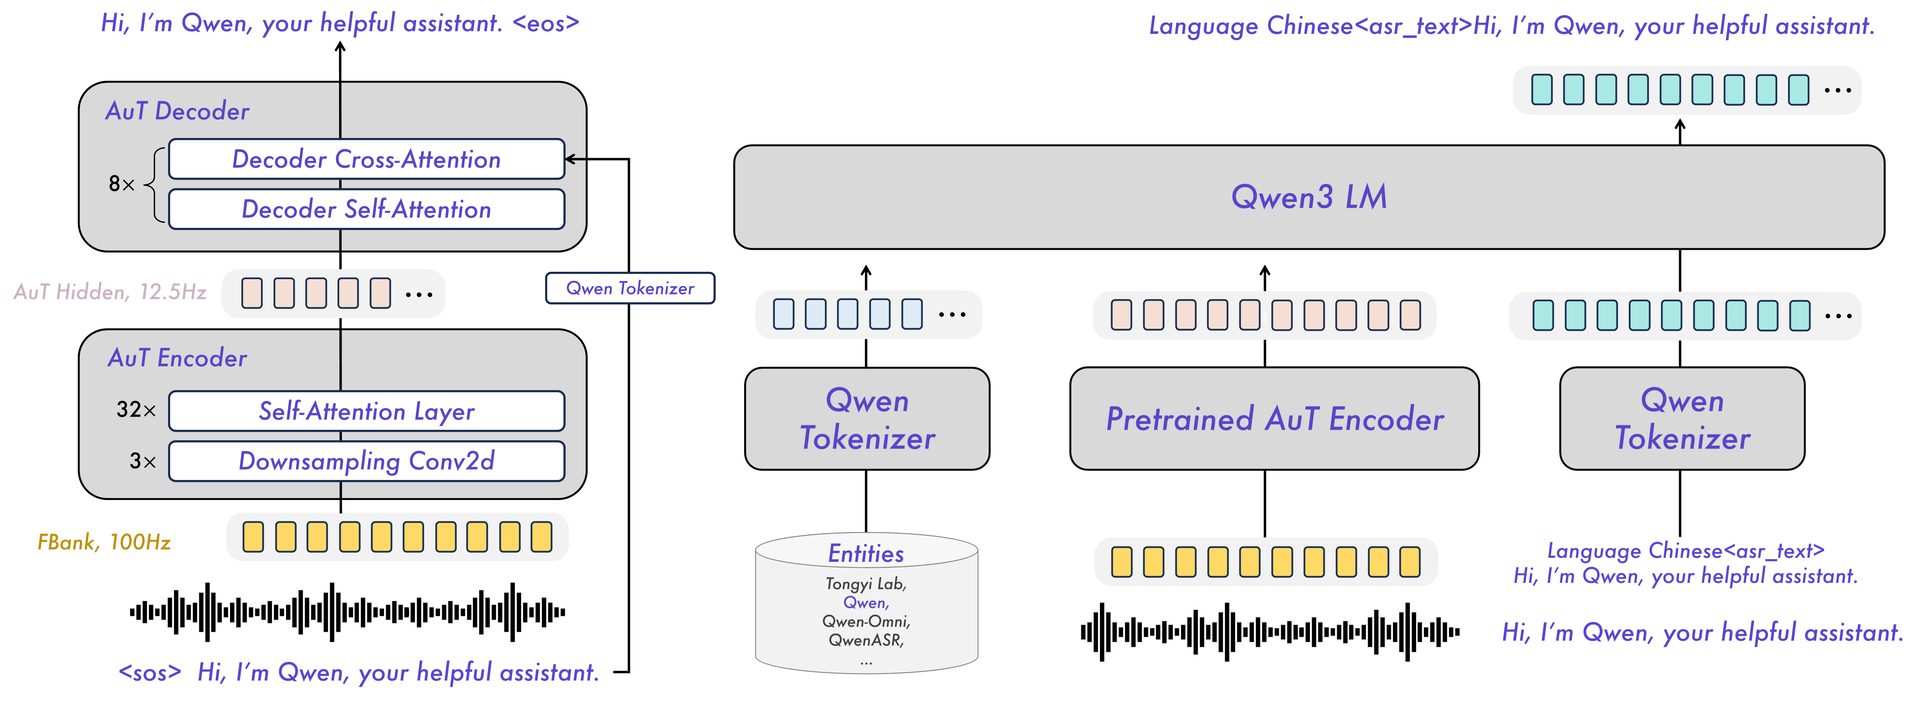
一小时的会议录音直接丢进去,是这类工具的日常用法,但模型侧有两个坎。整段音频一次性送进模型,生成有 token 上限,超出部分会被截掉;官方 transcribe 还会把长音频按 180 秒重新分块做批量推理,而批量长序列在 Apple MPS 上很慢。
这个接入服务的绕法是:以 120 秒为目标,在目标点附近找能量最低的位置切开,逐段顺序推理,每段结果再按偏移量拼回原始时间轴。
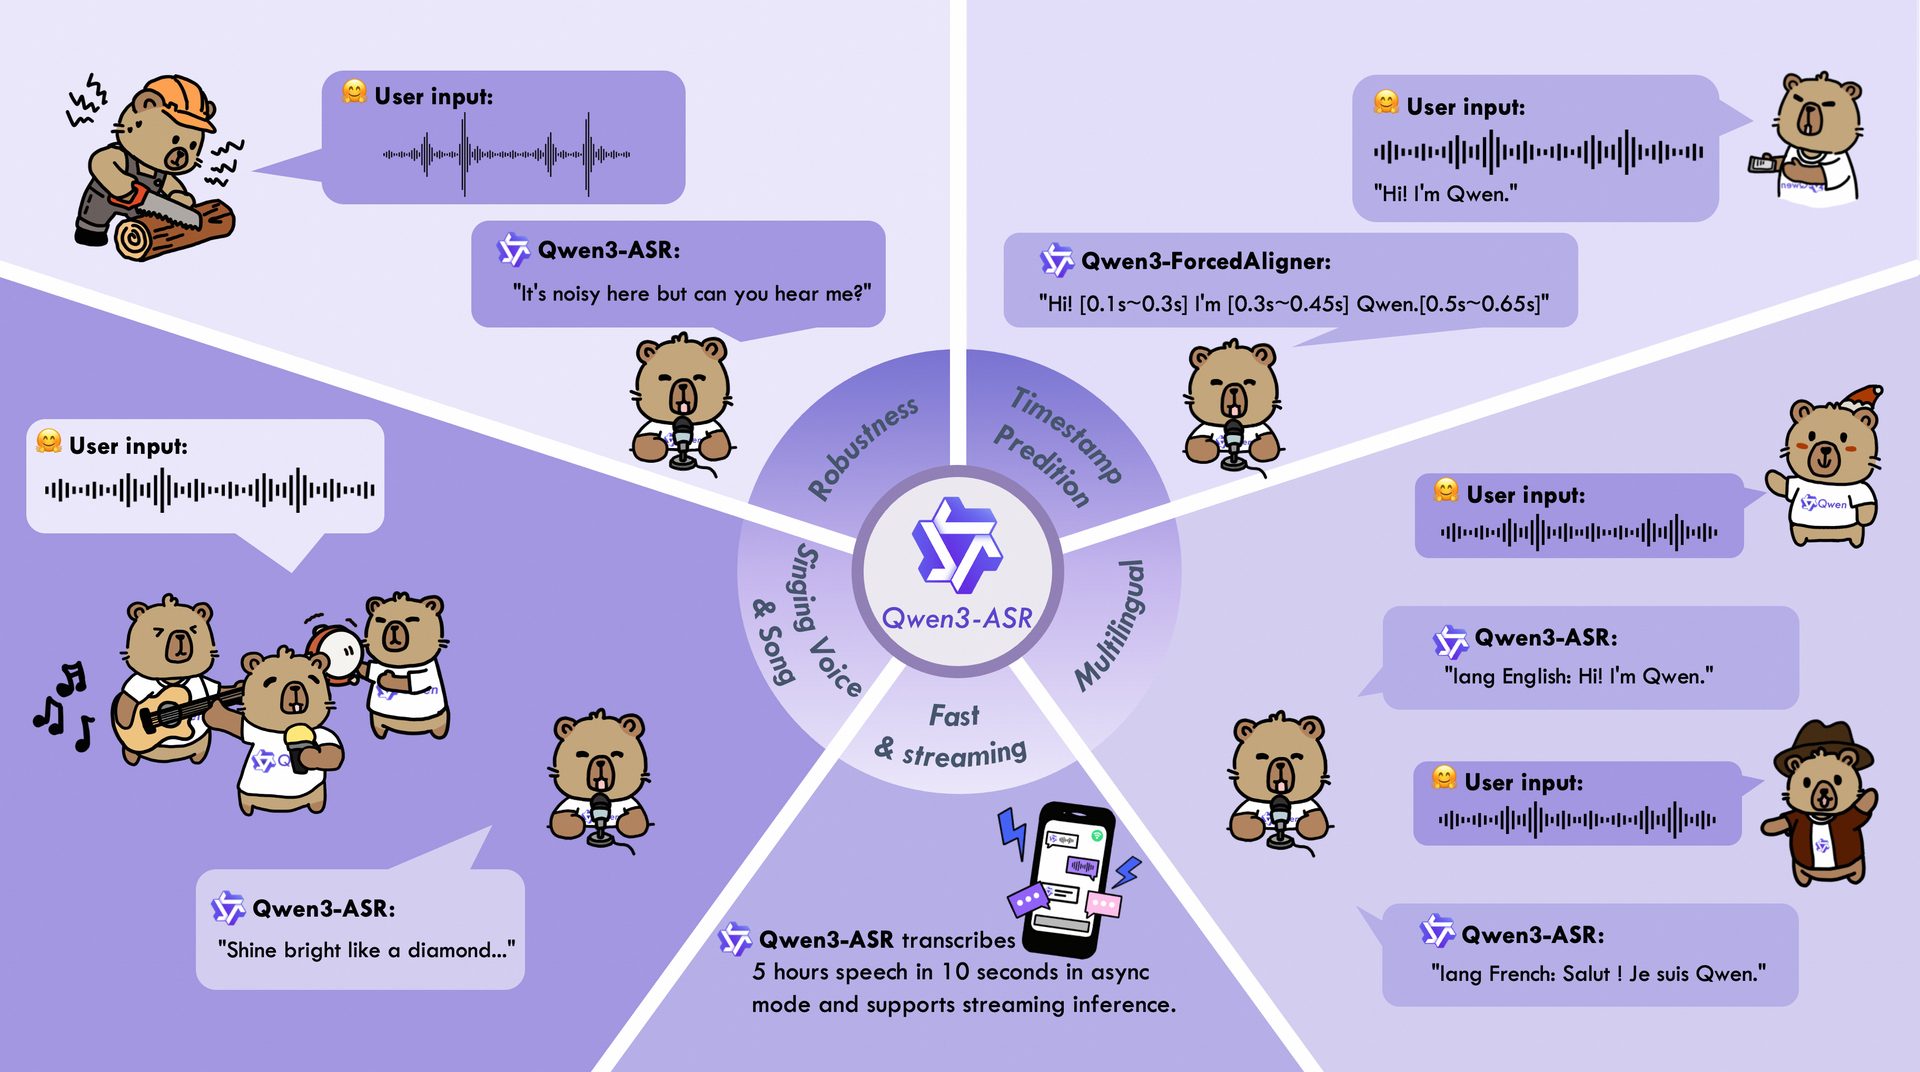
一个数字能说明差距,来自项目代码注释:200 秒音频整段交给模型,在 MPS 上跑了 57 分钟还没结束;改成分段顺序推理,同样音频约 3 分钟。按这个比例,两小时录音要一个多小时,不算快,但不用守着上传,也不按分钟计费。
结果以 records 列表返回,每条带 start、end、text。句子边界来自另一个 0.6B 强制对齐模型的词级时间戳,所以导出的字幕能贴着说话走。
模型再大也治不了截断,怎么切才是关键。
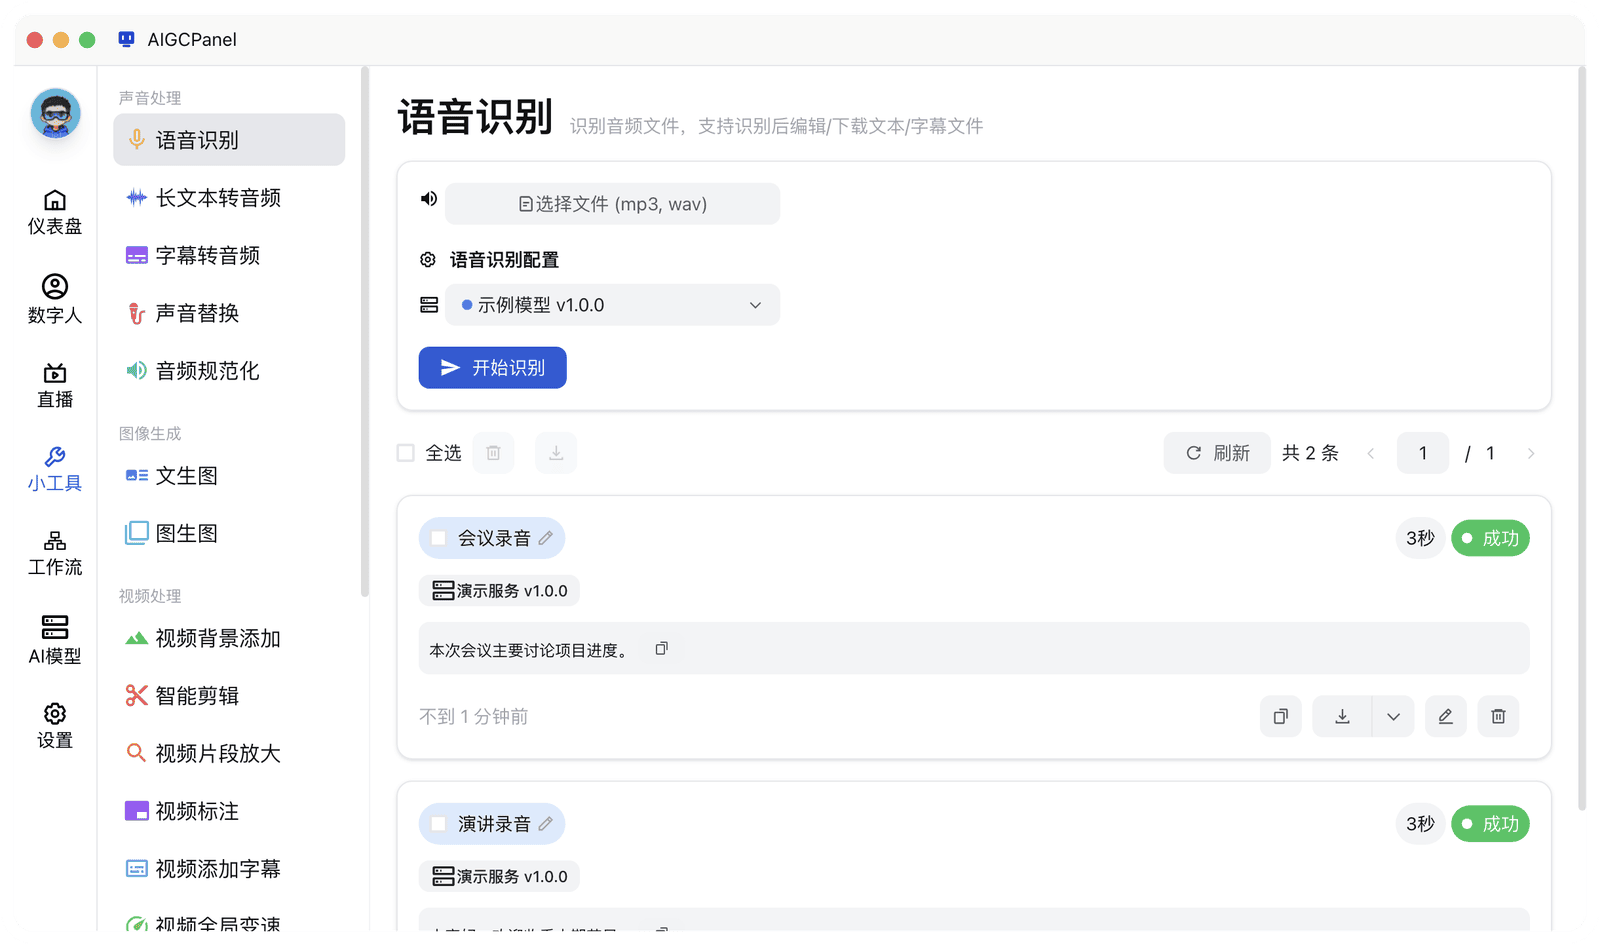
支持列表是 30 种语言加 22 种中文方言,共 52 种,粤语、闽南语、吴语、四川话都在里面。官方标称能处理演唱和带 BGM 的歌曲,不只是干净的朗读。
语言参数留「自动」,模型自己判断;知道是哪种语言时手动指定,结果更稳。人名、产品名、术语容易错,就在「上下文提示」里填几个关键词,专有名词的错字通常会少一些。
Qwen3-ASR-0.6B 和 Qwen3-ForcedAligner-0.6B 两个文件夹,缺一个服务启动就报错,文件夹名别改。回到「AI模型」页,右上角「本地模型」,选中解压后的目录,名称与下载的一致,点启动,状态变成「运行中」就可以用。想批量处理,把它拖进工作流当节点用。
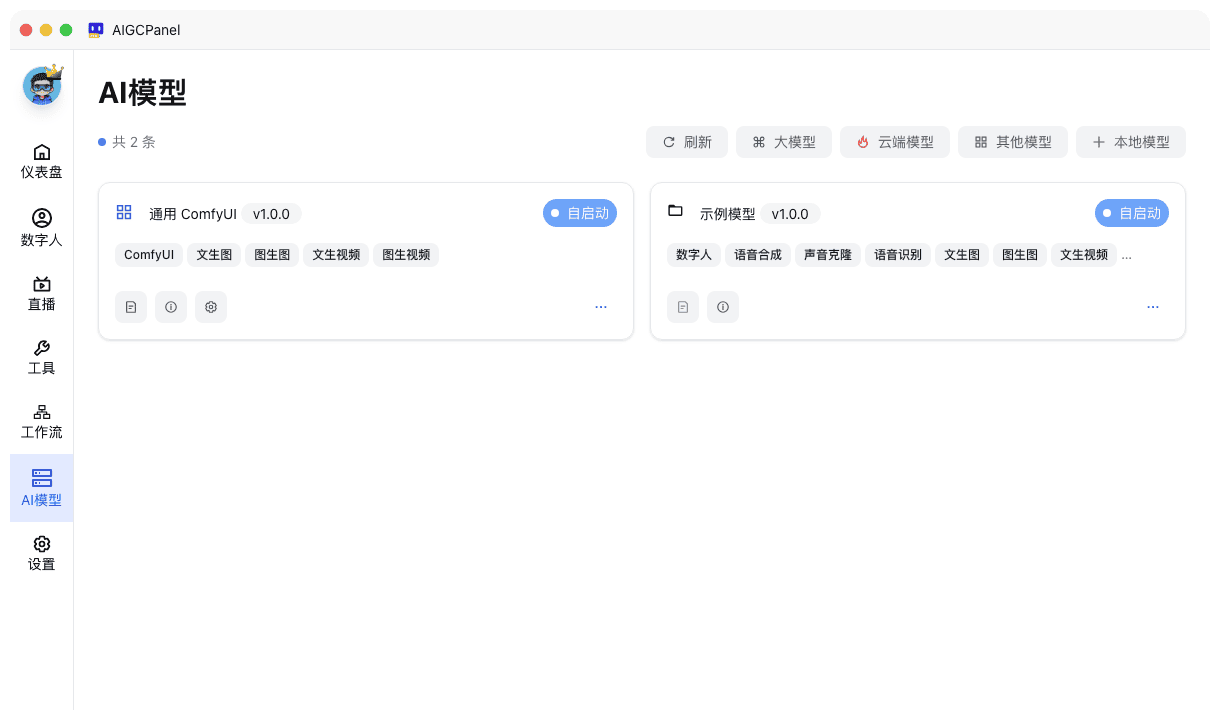
数字人视频合成、声音合成与声音克隆、25+ 音视频工具箱、工作流(VIP)。语音识别只是工具箱里的一格,转写完顺手加字幕、配音、剪片,都在同一个软件里。
要实时滚动的字幕、要区分说话人、中英混说严重、只有 CPU 又要转两小时,或者追求最高准确率——这些场景用 1.7B 或云端 API 更合适。0.6B 是个偏工程的选择,不是万能键。
aigcpanelmodels/,运行时不下载权重。Qwen3-ASR 由阿里通义千问团队开源,AIGCPanel 是 Apache-2.0 的桌面项目,本文对应的服务包是 server-Qwen3ASR06B v1.0.0。
别拿两小时录音当第一次试验。挑一段 5 分钟的通话记录先跑,合不合适,一段就知道。
音频躺在硬盘里是沉默的,转成文字才会开口。